Déployez votre IA privée
Vos données. Votre contrôle
Réduisez vos coûts cloud.
Utilisez votre IA sans compter chaque requête.
Quand une IA locale devient le meilleur choix
Voici les principaux cas d'usage métiers qui tirent pleinement parti d'une IA locale, classés par domaine d'application.
| Cas d'usage | Critère clé justifiant une IA locale |
|---|---|
| Code & R&D | Protection de la propriété intellectuelle |
| RH / Santé / Dossiers clients | Confidentialité stricte des données personnelles |
| Support & Services Clients | Intégration directe aux workflows internes |
| Sites isolés / Défense | Fonctionnement hors-ligne (air-gapped) |
| Gros volumes de documents | Coûts maîtrisés (pas de facturation au token) |
| Production | Optimisation & automatisation des processus |
| Secteurs réglementés | Conformité, souveraineté et traçabilité des données |
Nos Services Experts
Des solutions d'infrastructure sur mesure, conçues pour la performance et la sécurité.
IA Souveraine & Productivité Interne
Déployez des assistants IA d'entreprise (Code, Support, Analyse de documents) connectés à vos données confidentielles, sans dépendre du cloud.
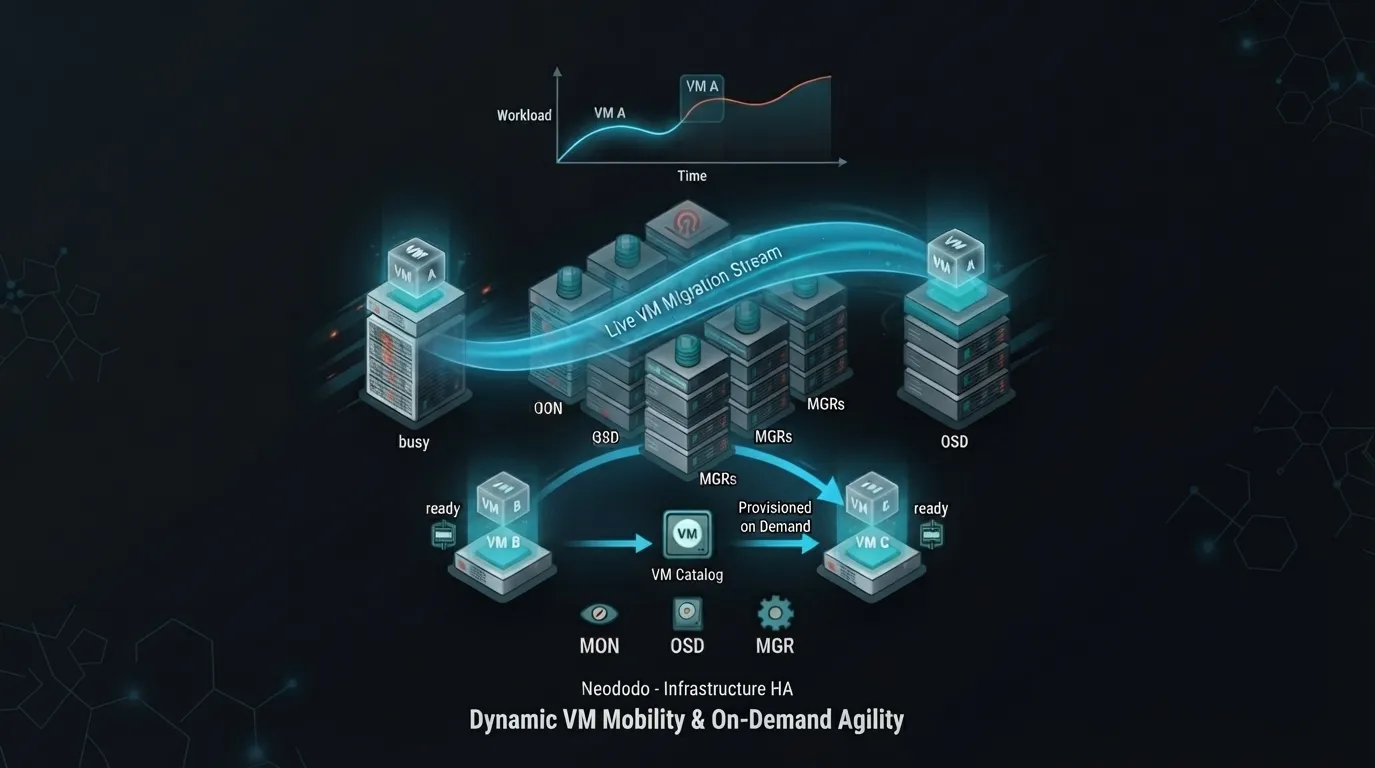
Agilité & Modernisation du SI
Stabilisez et accélérez le déploiement de vos applications métiers sans coupure d'activité.
Infrastructures Éco-Énergétiques
Conception locale et multi-sites avec bascule automatique et optimisation drastique de vos coûts électriques et serveur.
Nos Offres
Des formules adaptées à chaque étape de votre transformation numérique souveraine.
Starter IA
Idéal pour doter une équipe (ex: R&D ou Dev) d'un copilot souverain ou tester l'analyse documentaire en local.
- Serveur IA local 1-2 GPU
- Interface web intuitive
- Souveraineté totale dès la première semaine
Industrialisation
Idéal pour automatiser les flux de travail inter-services (RH, Juridique, Support).
- Migration de 3 à 10 apps vers conteneurs
- Orchestration autonome et pilotée
- Supervision 24/7 incluse
Souverain Complet
Pour les SI critiques exigeant un fonctionnement 100% continu (PCA/PRA) et une indépendance totale.
- Infrastructure hybride multi-sites
- Optimisation GPU continue
- Accompagnement dédié
Retour sur Investissement HA
Estimez vos économies avec une infrastructure SI en haute disponibilité
Paramètres de votre infrastructure
Résultats estimés
💡 Prédictibilité budgétaire : Contrairement aux abonnements Cloud/SaaS dont la facture augmente avec chaque utilisateur et chaque requête, votre matériel est amorti : votre ROI s'améliore à chaque interaction traitée en local.
Vos avantages concrets
- • Indépendance matérielle et logicielle
- • Disponibilité cible garantie (SLA)
- • Sauvegardes à froid et chaud
- • Gain de temps sur les opérations IT
⚠️ Ces estimations sont fournies à titre indicatif uniquement. Elles ne constituent pas une offre contractuelle. Un diagnostic personnalisé de votre infrastructure est nécessaire pour affiner les projections financières et techniques.
Cluster HA Ceph
Architecture de stockage distribué résiliente
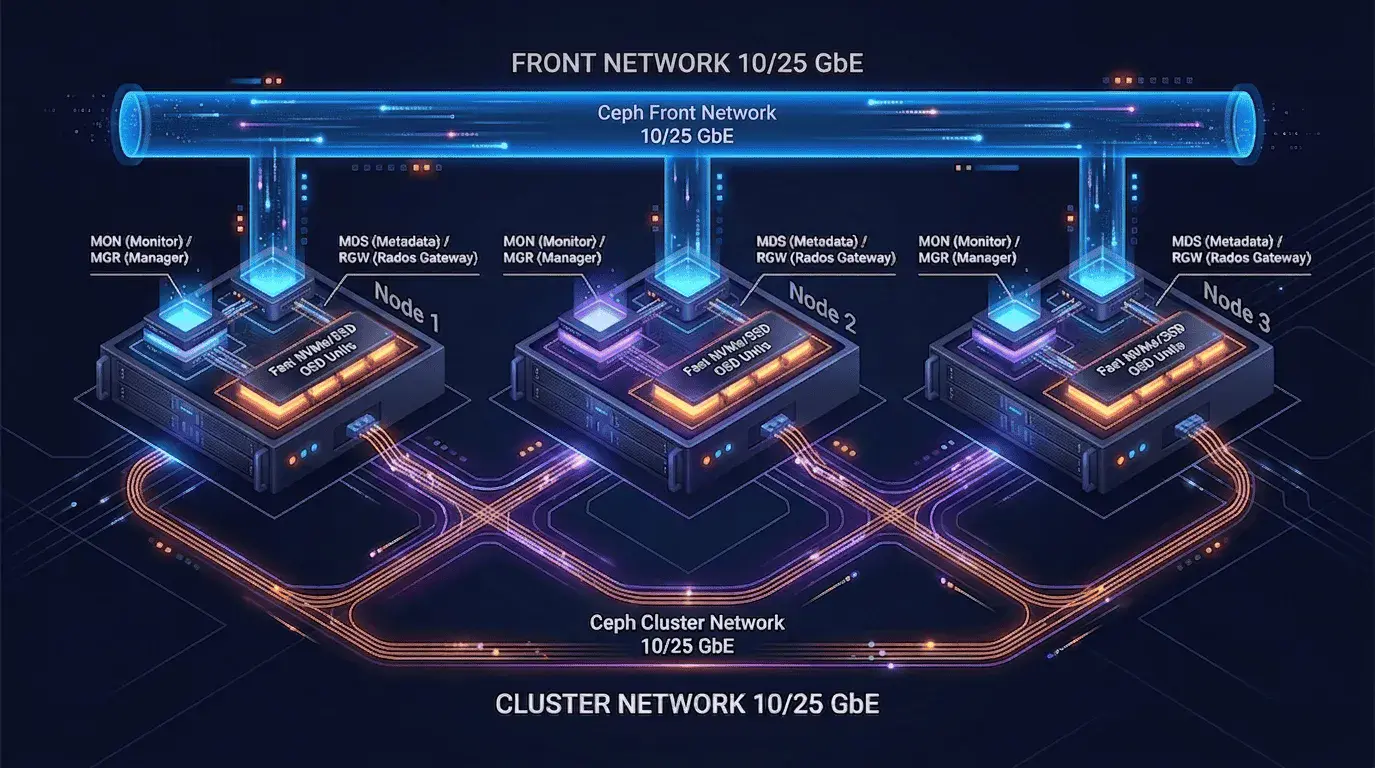
Cluster de Stockage Ceph Haute Disponibilité
Ce schéma illustre une architecture de stockage distribué Ceph résiliente et tolérante aux pannes, conçue sans point unique de défaillance (No Single Point of Failure).
- Résilience totale des données
- Pas de point unique de défaillance
- Stockage distribué et sécurisé
Choix des architectures GPU
Quel GPU choisir selon le modèle
LLMs Agentic, code, vision VL, text, compression de contexte, memoire, RAG
| Critère | Mac Mini/Studio (MLX) | NVIDIA DGX Spark | WorkStation / Serveur vLLM |
|---|---|---|---|
| Objectif principal | Inférence locale / Prototypage | Prototypage avancé / fine-tuning | Inférence d'entreprise (API multi-tenant) |
| Cas d'usage direct | Poste individuel / PME | Codeurs / R&D / Data scientists | Entreprise / Multi-utilisateurs |
| Atout majeur | VRAM massive à bas coût | Bande passante & Puissance brute | Optimisation du cache KV (PagedAttention/LMCache) |
| Flexibilité logicielle | Limitée à l'écosystème Apple/Metal | Standard de l'industrie (CUDA) | Open-source & multi-fournisseurs |
| Plateforme | Prefill typique (7-35B quant) | Commentaire |
|---|---|---|
| Nvidia CUDA (RTX/RTX Pro/DGX) | 5 000 – 15 000+ tok/s | Roi absolu, Écosystème très riche |
| AMD ROCm (Radeon PRO/Instinct) | 2 000 – 12 000 | Très bon, surtout Instinct |
| Intel SYCL (Arc/Arc Pro) | 1 000 – 2 100+ | Correct / bon, Écosystème restreint |
| Mac MLX (M5 Max/Ultra) | 1 000 – 2 700 | Comparable à Intel, meilleur en decode, Écosystème riche |
Le guide pour passer à l'échelle
Budgets, performances, matériel et mise en production : ce qu'il faut savoir avant de faire tourner votre IA sur vos propres GPU.
Faire tourner une IA en interne exige un ordre de grandeur sur les budgets et les performances attendus. Posséder son propre matériel change la donne à quatre niveaux.
Indépendance totale
S'affranchir de la dépendance envers les géants (OpenAI, Anthropic) et des fluctuations géopolitiques ou réglementaires.
Maîtrise des coûts
Un investissement de départ important, mais sans surprise ensuite : pas de quotas ni limitations. Seul le matériel physique dicte les limites.
Sécurité des données
Le code source, les instructions et le contexte de l'entreprise restent strictement confidentiels et internes.
Stabilité des modèles
Plus de risque de voir un modèle parfait disparaître du jour au lendemain, au gré des choix d'un fournisseur.
De 4 000 € à +90 000 € : une échelle continue
Cinq paliers de configuration, mini, Pro, mono-GPU, jusqu'au cluster lourd. Cliquez sur un palier pour sauter directement à la configuration.
Pourquoi NeoDodo ?
Souveraineté
Vos données restent chez vous. Zéro exposition cloud externe.
Performance
GPU derniers générations optimisés pour l'inférence LLM.
Orchestration IA
Réduire la complexité, optimiser les cycles et diminuer les coûts
Proximité
Présence à La Réunion et en Métropole. Un interlocuteur unique.
Prêt à prendre le contrôle ?
Demandez votre diagnostic et transformez vos infrastructures en plateformes souveraines.
Plus rapides, plus fiables, plus rentables.